引言
注意力机制是 Transformer、GPT-3 等现代自然语言处理系统的基本组成部分。这些系统采用编码器—解码器架构:编码器将输入句子映射为固定长度的向量,再由解码器将其转换为输出句子。这种架构在处理较长的输入句子时会出现性能下降。注意力机制可以有效缓解这一问题:它识别输入句子中的相关部分,供编码器进行映射,从而避免将整个输入句子压缩为固定长度向量所带来的困难。
注意力机制最早由 Bahdanau, D. 等人在文献 [1] 中提出,并作为 RNN 编码器—解码器 架构的一部分实现。该神经网络模型在英法翻译任务中取得了当时最先进的性能,并发表于 ICLR 2015。截至 2024 年,这篇论文已被引用超过 30,000 次。
RNN 编码器—解码器模型由分别承担编码器和解码器功能的两个 RNN 组成。编码器 RNN 将输入词 $x_{j}$ 映射为一系列隐藏状态 $h_{j}$($j = 1, 2, …, T_{x}$)。随后,这些隐藏状态用于确定预测第 $i$ 个目标词所需的上下文向量 $c_{i}$。也就是说,解码器 RNN 使用上一个隐藏状态 $s_{i-1}$、上一个目标词 $y_{i-1}$ 和当前上下文向量 $c_{i}$ 作为输入,预测第 $i$ 个目标词。
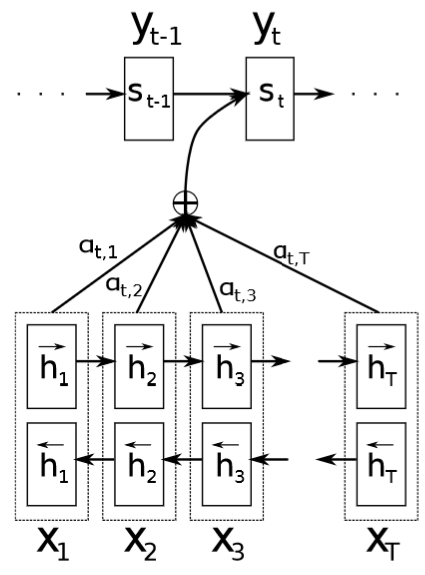
图 1 RNN 编码器—解码器架构中的注意力机制示意图 [1]
注意力机制的关键在于上下文向量 $c_{i}$ 的定义。上下文向量定义为所有隐藏状态的加权和:
$$ c_{i} = \sum_{j=1}^{T_{x}}\alpha_{ij}h_{j}, $$
其中,系数 $\alpha_{ij}$ 衡量各源词 $x_{j}$ 与第 $i$ 个目标词之间的相关程度。这些系数通过如下 softmax 函数计算:
$$ \alpha_{ij} = \frac{\exp(e_{ij})}{\sum_{j=1}^{T_{x}}\exp(e_{ij})}, $$
其中 $e_{ij} = a(s_{i-1}, h_{j})$。函数 $a$ 是与 RNN 联合训练的前馈神经网络,用来预测各源词对于生成下一个目标词的相关程度。直观地说,对于较长的源句子,大多数源词会被赋予较低的权重。这有效避免了将整个句子映射为固定长度向量的问题,显著提升了模型处理长输入句子的性能。
由于权重 $\alpha_{ij}$ 衡量源词和目标词之间的相关程度,它们也可以用于词语对齐。这解释了论文标题“Neural machine translation by jointly learning to align and translate”(通过联合学习对齐与翻译实现神经机器翻译)的含义。
参考文献
- Bahdanau, D., Cho, K., & Bengio, Y. (2014). Neural machine translation by jointly learning to align and translate. arXiv preprint arXiv:1409.0473.
- Cho, K., Van Merriënboer, B., Gulcehre, C., Bahdanau, D., Bougares, F., Schwenk, H., & Bengio, Y. (2014). Learning phrase representations using RNN encoder-decoder for statistical machine translation. arXiv preprint arXiv:1406.1078.
- Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to sequence learning with neural networks. Advances in neural information processing systems, 27.