引言
Transformer 是一种用于序列转换的机器学习模型,具有预测准确率高、计算复杂度低和计算并行度高等特点。它是 GPT-3 等现代大语言模型的基本构件,而这类模型被视为实现通用人工智能(AGI)的有力候选。Transformer 最早由谷歌的一个研究团队在 NIPS 2017 上提出。相关论文“Attention Is All You Need”[1] 截至 2024 年已被引用超过 100,000 次,显示了 Transformer 对自然语言处理研究的巨大影响。本文将介绍 Transformer 的架构,并分享我对其工作原理的理解。
背景
已有的基于循环神经网络(RNN)和注意力机制的神经序列转换模型,在机器翻译任务中达到了当时最先进的性能 [2]。然而,RNN 固有的顺序计算特性使得利用并行计算加速训练变得困难,导致训练耗时较长,并阻碍了大规模自然语言处理模型的发展。
Transformer 架构
Transformer 的基本架构如下图所示。与此前许多神经序列转换模型一样,Transformer 采用编码器—解码器架构。编码器由 6 个相同结构的层组成,每层包含两个子层:一个自注意力函数和一个前馈神经网络。解码器同样由 6 个相同结构的层组成,但每层额外包含一个自注意力函数。编码器和解码器都使用残差连接来提高训练准确率 [3]。输入文本首先通过嵌入层转换为 512 维向量,再对向量施加位置编码,将文本的顺序信息注入模型,然后交由注意力函数和神经网络进一步处理。
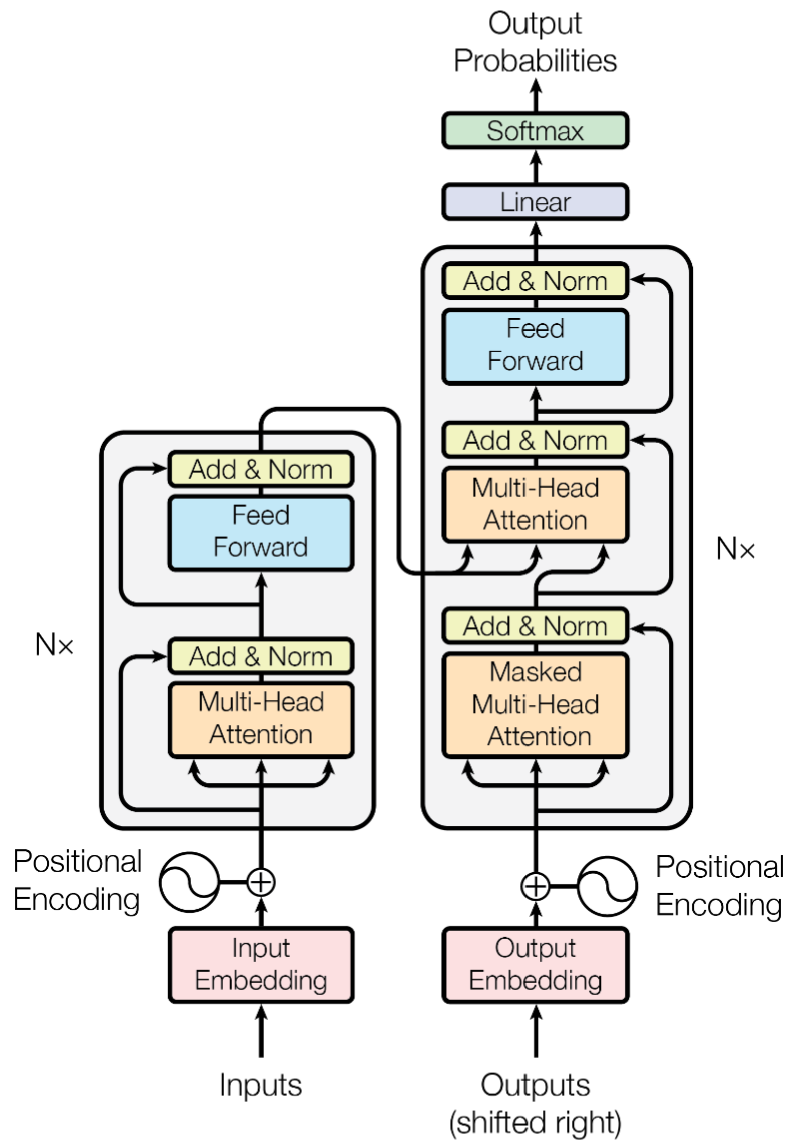
图 1 Transformer 架构 [1]
多头注意力
Transformer 使用多头注意力函数识别序列内部以及两个不同序列之间的相关性。给定输入向量(也称查询)$Q$ 和由键值对 $(K, V)$ 组成的字典,多头注意力函数通过计算输入向量与所有键之间的点积 $QK^{T}$ 来识别相关性。注意,字典中的所有键和值都是 512 维向量,因此上述点积运算是合法的。注意力函数的输出是字典中各个值的加权平均,权重系数由点积的 softmax 函数给出。
$$ {\rm Attention}(Q, K, V) = {\rm softmax}(\frac{QK^{T}}{\sqrt{d_{k}}})V. $$
这里,缩放因子 $\sqrt{d_{k}}$ 用于抵消向量维度增加时点积增大的影响,以避免梯度减小以及训练准确率下降。
不难看出,注意力函数用点积计算两个序列的相关性,这隐含地假设各种相关性都应被同等对待。但在实际预测中,某些相关性比其他相关性更重要。为了赋予 Transformer 这种区分能力,实际的注意力函数首先将查询向量以及所有键和值投影到若干子空间,再在各个子空间中分别计算注意力函数。各子空间中计算得到的注意力(单头注意力)被拼接起来,形成多头注意力函数的最终输出。投影参数需要通过优化获得,因此 Transformer 能够自适应地判断不同类型相关性的相对重要程度。
多头注意力函数可以通过现有的矩阵乘法算法高效计算,其计算复杂度相对较低。此外,多头注意力函数的向量化形式适合使用并行计算加速。这两个优势使其成为相对于传统 RNN 注意力机制更有吸引力的选择。
前馈神经网络
编码器和解码器的每一层都包含一个全连接前馈神经网络子层,位于多头注意力子层之后。该前馈神经网络子层由两次线性变换以及一个 ReLU 激活函数组成,隐藏层维度为 2048。
$$ {\rm FFN}(x) = \max(0, xW_{1}+b_{1})W_{2} + b_{2}. $$
这一前馈神经网络为模型提供了非线性激活函数;仅从多头注意力函数的构造来看,模型原本缺少这一部分。
观察、评论与趣事
- 所有作者均被标注为“同等贡献”。
- Transformer 模型在 8 块 P100 GPU 上训练 3.5 天后,在 WMT 2014 英法翻译任务中刷新了当时的最佳结果。
- Transformer 有两个主要优势:兼容并行计算以及较低的计算复杂度,使其成为未来大语言模型中很有潜力的基本构件。
- 论文 [1] 提出多头注意力函数,以取代基于循环神经网络的注意力函数;后者因其固有的顺序计算特性而具有较高的计算成本。
- ResNet 最初是为改善深度学习模型在计算机视觉任务中的性能而提出的,而这里将它引入了自然语言处理模型。
- Transformer 结合多头注意力函数和全连接前馈神经网络,计算与加权隐藏状态相对应的量;加权隐藏状态是注意力机制中的重要组成部分 [2]。
- Transformer 使用位置编码向模型注入顺序信息。该编码根据文本的位置为嵌入向量添加偏移量。关键在于,位置编码在引入顺序信息的同时,保留了模型对并行计算的兼容性。
参考文献
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., … & Polosukhin, I. (2017). Attention is all you need. Advances in neural information processing systems, 30.
- Bahdanau, D., Cho, K., & Bengio, Y. (2014). Neural machine translation by jointly learning to align and translate. arXiv preprint arXiv:1409.0473.
- He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep residual learning for image recognition. In Proceedings of the IEEE conference on computer vision and pattern recognition (pp. 770-778).